Doble Grado en Análisis de Negocios y Administración y Dirección de Empresas (UFV)
Madrid
Busca asignaturas, publicaciones o creadores
Asignaturas de Doble Grado en Análisis de Negocios y Administración y Dirección de Empresas (UFV)
Asignatura
arrow_downward
4º
•
10 posts
5º
•
0 posts
1º
•
5 posts
2º
•
0 posts
3º
•
1 posts
4º
•
0 posts
4º
•
0 posts
2º
•
5 posts
3º
•
1 posts
4º
•
0 posts
4º
•
0 posts
1º
•
8 posts
1º
•
9 posts
2º
•
0 posts
2º
•
10 posts
3º
•
0 posts
3º
•
0 posts
5º
•
0 posts
3º
•
1 posts
2º
•
8 posts
5º
•
0 posts
3º
•
3 posts
5º
•
0 posts
4º
•
0 posts
5º
•
0 posts
2º
•
0 posts
3º
•
0 posts
3º
•
2 posts
3º
•
0 posts
3º
•
2 posts
3º
•
1 posts
2º
•
3 posts
1º
•
3 posts
1º
•
5 posts
1º
•
5 posts
1º
•
9 posts
1º
•
9 posts
1º
•
0 posts
2º
•
0 posts
2º
•
0 posts
4º
•
2 posts
4º
•
0 posts
2º
•
4 posts
4º
•
0 posts
3º
•
1 posts
4º
•
0 posts
3º
•
2 posts
1º
•
8 posts
2º
•
9 posts
2º
•
1 posts
1º
•
2 posts
2º
•
6 posts
3º
•
3 posts
3º
•
1 posts
Últimas publicaciones de Doble Grado en Análisis de Negocios y Administración y Dirección de Empresas (UFV)
Diapositivas del capitulo 3: agentes que resuelven problemas, estrategias de busqueda no informada y busqueda heuristica, con los algoritmos y los ejemplos. 109 diapositivas en ingles.
Diapositivas del capitulo 2: agentes y entornos, como se define un problema de inteligencia artificial, tipos de agente y el ejemplo del aspirador programado en Python. 60 diapositivas en ingles.
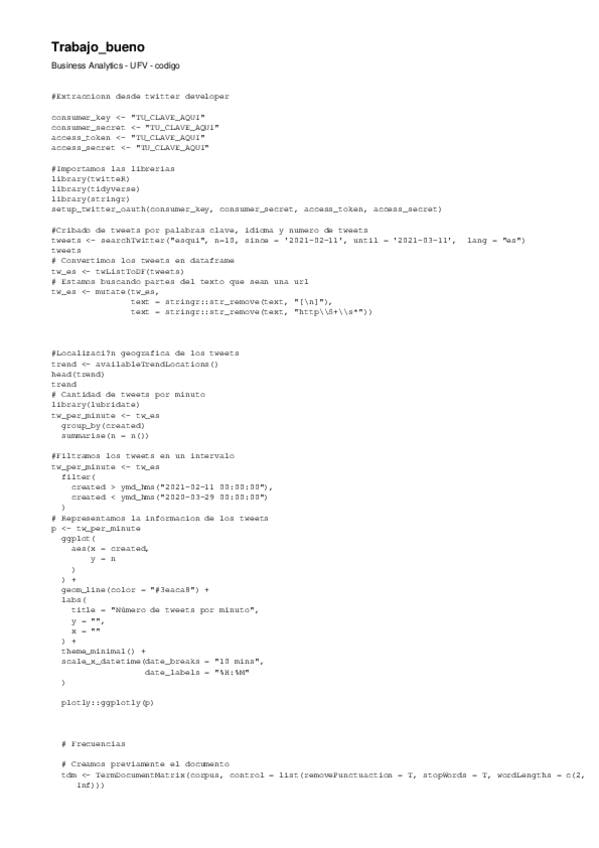
Trabajo entero en R: conexion con la API de Twitter, cribado de tuits por palabras clave, idioma y numero, tokenizacion y recuento de palabras. Las claves van sustituidas por un marcador. 2 paginas.
Diapositivas de introduccion al text mining: los cuatro pasos del proyecto, extraccion de datos de Twitter con la API, huso horario, bolsa de palabras y analisis. 8 diapositivas.
Diapositivas del nucleo del tema: limpieza de texto y tokenizacion, bolsa de palabras, visualizacion con nube de palabras, el peso TF-IDF y los diccionarios de sentimientos. 17 diapositivas.
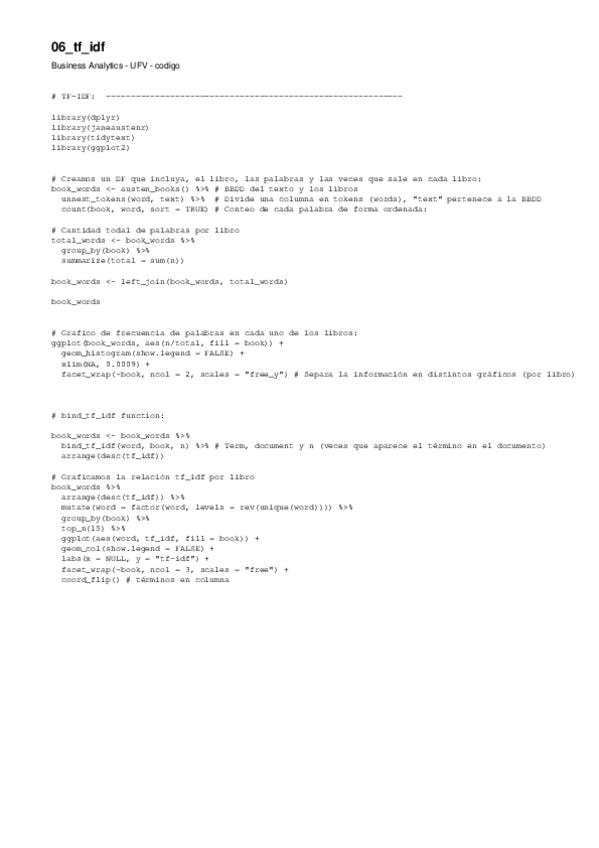
Script en R que calcula el TF-IDF con tidytext sobre el corpus de janeaustenr como ejemplo, para ver como pesa cada termino en cada documento.
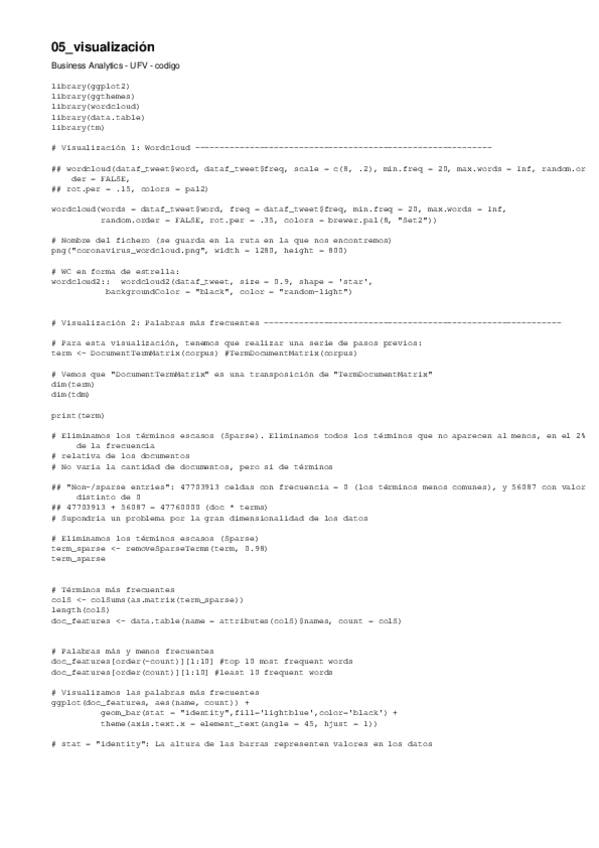
Script en R con las visualizaciones del analisis: la nube de palabras con wordcloud y los graficos de frecuencias con ggplot2 y ggthemes.
Script en R que calcula las frecuencias de los terminos de la bolsa de palabras y las prepara para representarlas.
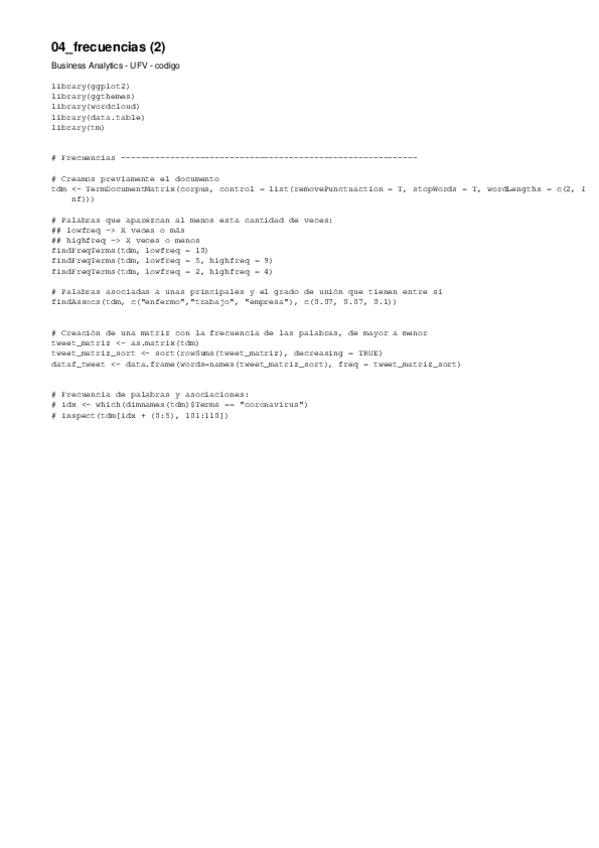
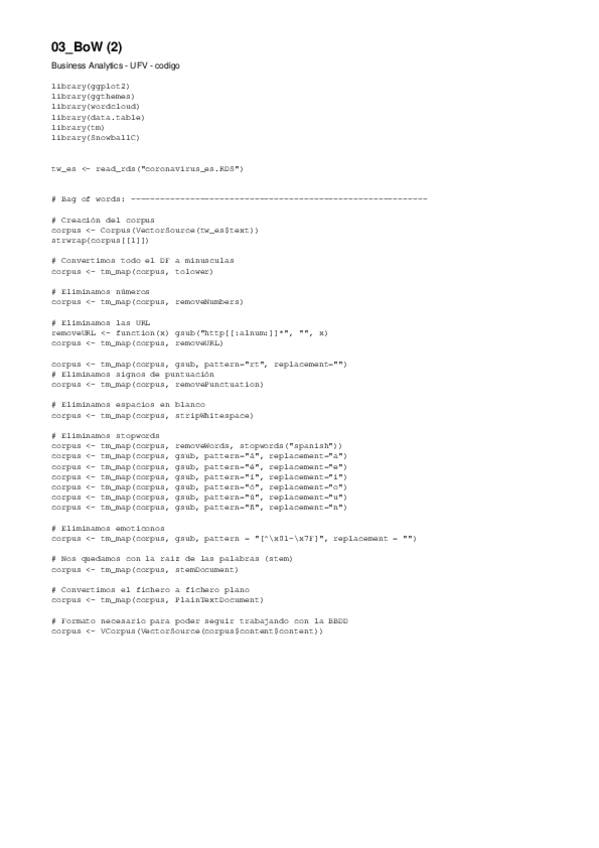
Script en R que construye la bolsa de palabras con tm y SnowballC: limpieza del texto, tokenizacion y matriz de terminos, partiendo del fichero de tuits guardado.
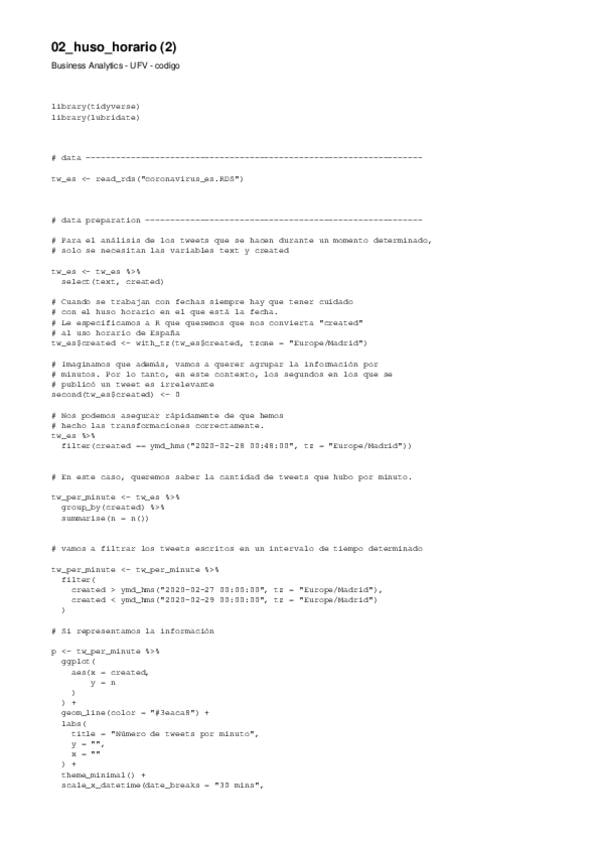
Script en R que ajusta el huso horario de los tuits descargados usando tidyverse y lubridate, dejandolos listos para el analisis temporal.